
 7 min de lecture
La première automatisation devrait parfois être une suppression
Une tâche prend quinze minutes. Elle revient trois fois par jour. Quelqu’un sort la calculatrice : quarante-cinq minutes par jour, environ deux cent vingt jours par an, le chiffre commence à avoir fière allure dans un tableau. Le dossier semble réglé.
Automatisons.
Pas si vite. Il manque une question légèrement importante :
Pourquoi faisons-nous encore cette tâche ?
Certains processus répétitifs ne sont pas inefficaces, ils sont inutiles. Un reporting peut être parfaitement automatisable sans être lu par personne. Une validation a peut-être été ajoutée six ans plus tôt après un incident qui ne peut techniquement plus se reproduire. Une ressaisie entre deux logiciels existe parfois simplement parce que personne n’a vérifié s’ils savaient déjà communiquer.
Automatiser une absurdité a un avantage : elle devient beaucoup plus rapide. Elle reste une absurdité.
Avant de choisir un outil, la première étape consiste donc parfois à supprimer, fusionner ou simplifier le processus. Le meilleur workflow est, à l’occasion, celui qu’on ne construira jamais.
Un bon candidat possède un début, une fin et quelques règles stables
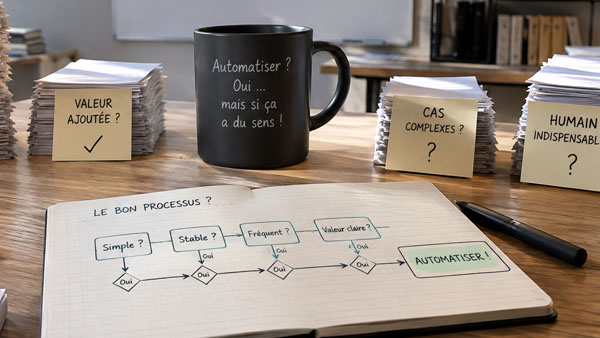
Les processus les plus faciles à automatiser ont en général plusieurs points communs. Ils se répètent. Leur déclencheur est identifiable. Les données nécessaires existent. Les principales règles restent assez stables. Et on sait reconnaître un résultat correct.
Une demande arrive dans une boîte définie. Une facture suit un format exploitable. Une échéance déclenche une relance. Un dossier change d’état quand un ensemble de conditions est réuni. Tout cela se prête assez bien à l’automatisation.
À l’inverse, si chaque occurrence impose une réunion de vingt minutes pour décider ce que signifie le mot « normalement », le chantier demande sans doute encore un peu de clarification.
Le cadre de gestion des risques liés à l’IA du NIST part justement de la compréhension du contexte, des objectifs, des bénéfices attendus, des personnes concernées et des limites d’un système. Sa fonction Map sert notamment à déterminer si l’usage envisagé répond bien au problème réel. Le document ne commence pas par le choix d’un modèle ou d’un outil, et ce n’est pas un hasard.
Beaucoup de projets démarrent pourtant par :
Nous voulons utiliser l’IA pour…
La phrase utile serait plutôt :
Nous voulons résoudre…
Quelques mots de différence peuvent épargner plusieurs mois d’enthousiasme mal placé.
La fréquence compte, mais la friction compte davantage
Une tâche réalisée cinq cents fois par mois attire naturellement l’attention. Mais une opération qui n’a lieu que dix fois peut coûter plus cher si elle mobilise quatre personnes, interrompt un responsable, réclame des informations dispersées ou provoque régulièrement des erreurs.
Le coût d’un processus ne se résume pas au chronomètre. Il y a aussi :
- le coût des interruptions ;
- le temps d’attente entre deux personnes ;
- la recherche d’informations ;
- la vérification ;
- les erreurs et leurs corrections ;
- la dépendance à une personne ;
- le temps nécessaire pour former un nouveau collaborateur.
Et puis il y a cette tâche que tout le monde repousse au vendredi après-midi, avec un optimisme collectif assez mystérieux.
Une bonne analyse s’intéresse donc moins à la durée brute qu’à la friction produite autour du travail. Un contrôle de deux minutes peut être un excellent candidat s’il interrompt trente fois une journée. Une opération de vingt minutes peut très bien rester telle quelle si elle demande un jugement rare, utile, exercé par la bonne personne.
Il faut compter les exceptions avant de célébrer le scénario nominal
Imaginons un workflow qui traite mille dossiers par mois. Sur huit cent cinquante, les règles sont simples. Sur cent, il manque une information. Sur quarante, une particularité métier apparaît. Sur dix, quelqu’un doit prendre une décision sensible.
On tient déjà une architecture possible :
- les huit cent cinquante premiers dossiers avancent automatiquement ;
- les cent suivants déclenchent une demande d’information ;
- les quarante cas particuliers sont préparés par le système ;
- les dix situations sensibles arrivent devant une personne.
On n’a pas « automatisé le processus ». On a automatisé la partie du processus qui méritait de l’être.
Cette manière de raisonner par tâches rejoint les travaux de l’OIT sur l’exposition des métiers à l’IA générative. L’étude ne traite pas chaque profession comme un bloc indivisible : elle examine des milliers de tâches pour estimer ce que la technologie peut réellement transformer. Cette granularité permet de distinguer l’exposition d’un métier de sa disparition.
La même discipline sert dans une entreprise. Ne demandez pas :
Peut-on automatiser la comptabilité ?
La question est trop large pour produire une réponse exploitable. Demandez plutôt :
Parmi les opérations qui composent ce travail, lesquelles sont déterministes, lesquelles peuvent être préparées et lesquelles exigent un jugement ?
Là, le projet commence à prendre une forme raisonnable.
Le coût d’une erreur décide souvent du niveau d’autonomie
Une IA qui classe mal un email non critique peut être agaçante. Un système qui déclenche un remboursement, modifie un contrat ou envoie une information confidentielle à cause d’une mauvaise interprétation relève d’une tout autre conversation.
Deux automatisations qui font gagner le même temps peuvent donc justifier des niveaux d’autonomie très différents.
Le NIST définit le risque en combinant la probabilité d’un événement et l’ampleur de ses conséquences. Il recommande de tenir compte du contexte réel, des impacts possibles et de la tolérance au risque propre à l’organisation. Le cadre insiste aussi sur l’écart entre les résultats mesurés en environnement contrôlé et ceux qu’on observe dans l’usage réel.
On peut le résumer simplement :
plus l’erreur est chère, réglementée, irréversible ou difficile à détecter, moins on improvise.
Et parfois, la meilleure automatisation n’exécute aucune action sensible. Elle prépare, elle vérifie, elle alerte, puis elle laisse une personne décider. C’est déjà beaucoup.
Les données doivent être accessibles et suffisamment propres
Un processus peut paraître idéal sur le papier, puis buter sur un détail : l’information nécessaire n’existe pas sous une forme exploitable. Elle se trouve dans des emails. Dans des fichiers nommés FINAL_v3_bis. Dans un champ libre que chacun remplit à sa façon. Ou dans la mémoire de quelqu’un qui part en congé jeudi.
Avant d’automatiser, il faut donc vérifier :
- où se trouvent les données ;
- qui peut y accéder ;
- si elles sont structurées ;
- si elles sont fiables ;
- si leur usage est autorisé ;
- et ce qui se passe quand elles sont absentes.
Une automatisation n’améliore pas magiquement une donnée médiocre. Elle peut seulement la propager beaucoup plus efficacement. Ce n’est pas tout à fait la même promesse.
Le processus doit avoir un propriétaire
Une automatisation sans responsable finit souvent dans une zone floue. Tout le monde l’utilise, personne ne décide vraiment de ses évolutions. Les règles changent, mais le workflow continue d’appliquer celles de l’an dernier. Une anomalie apparaît, et chacun suppose que quelqu’un d’autre la surveille.
Avant de construire, il faut donc identifier une personne ou une équipe capable de répondre à quelques questions :
- Quel résultat attendons-nous ?
- Qui valide les règles ?
- Qui traite les exceptions ?
- Qui décide qu’une évolution est nécessaire ?
- Qui peut arrêter le système en cas de problème ?
Le propriétaire n’a pas besoin de développer la solution. Il doit pouvoir comprendre ce qu’elle fait et assumer les décisions métier qui l’entourent.
Le succès doit être mesurable autrement que par « ça fonctionne »
« Gagner du temps » est une intention, pas encore une mesure. Avant le projet, il faut décrire ce qu’on veut vraiment changer :
- réduire le délai moyen de traitement ;
- diminuer le nombre de demandes oubliées ;
- supprimer une ressaisie ;
- réduire les erreurs ;
- raccourcir la montée en compétence ;
- rendre le suivi moins dépendant de la mémoire individuelle ;
- permettre à l’équipe d’absorber un pic d’activité.
Après le déploiement, on compare. Et il arrive que le résultat déçoive. C’est mauvais pour la petite musique triomphale de la présentation finale, mais excellent pour l’entreprise : elle sait désormais ce qui marche et ce qui ne mérite pas d’être étendu.
Une grille simple permet déjà de faire beaucoup de tri
Quand un processus semble intéressant, quelques questions suffisent pour commencer :
- Est-il réellement nécessaire ?
- Est-il suffisamment fréquent, coûteux ou irritant ?
- Son début et son résultat sont-ils identifiables ?
- Les données nécessaires existent-elles ?
- Ses règles sont-elles relativement stables ?
- Combien d’exceptions produit-il ?
- Quel est le coût d’une erreur ?
- Qui conserve la responsabilité du processus ?
- Comment mesurerons-nous le résultat ?
Si les réponses restent floues, cela ne veut pas dire que l’automatisation est impossible. Cela veut simplement dire que la prochaine étape n’est probablement pas encore de choisir une plateforme, un agent ou un modèle.
Et c’est très bien. L’entreprise vient déjà d’éviter d’automatiser quelque chose qu’elle ne comprenait pas. C’est un premier gain tout à fait honorable.